Lokale KI oder Cloud? Fünf Stufen für Schweizer Unternehmen
Lokale KI oder Cloud? Fünf Stufen für Schweizer Unternehmen
Die Frage kommt fast immer in der zweiten Hälfte des Erstgesprächs. Nicht "Was kostet das?", sondern: "Und wo liegen dann unsere Daten?" Oft folgt gleich die nächste: "Müssen wir die KI nicht einfach lokal betreiben?"
Eine gute Frage. Und eine, auf die "bei OpenAI" selten die ganze Antwort ist. Denn die KI ist kein einzelner Ort. Dasselbe Sprachmodell kann in Virginia laufen, in Zürich, in einem Rechenzentrum in Paris oder auf einem Rechner unter Ihrem Pult. Das Modell ist dasselbe oder zumindest vergleichbar. Der Weg, den Ihre Daten nehmen, ist es nicht.
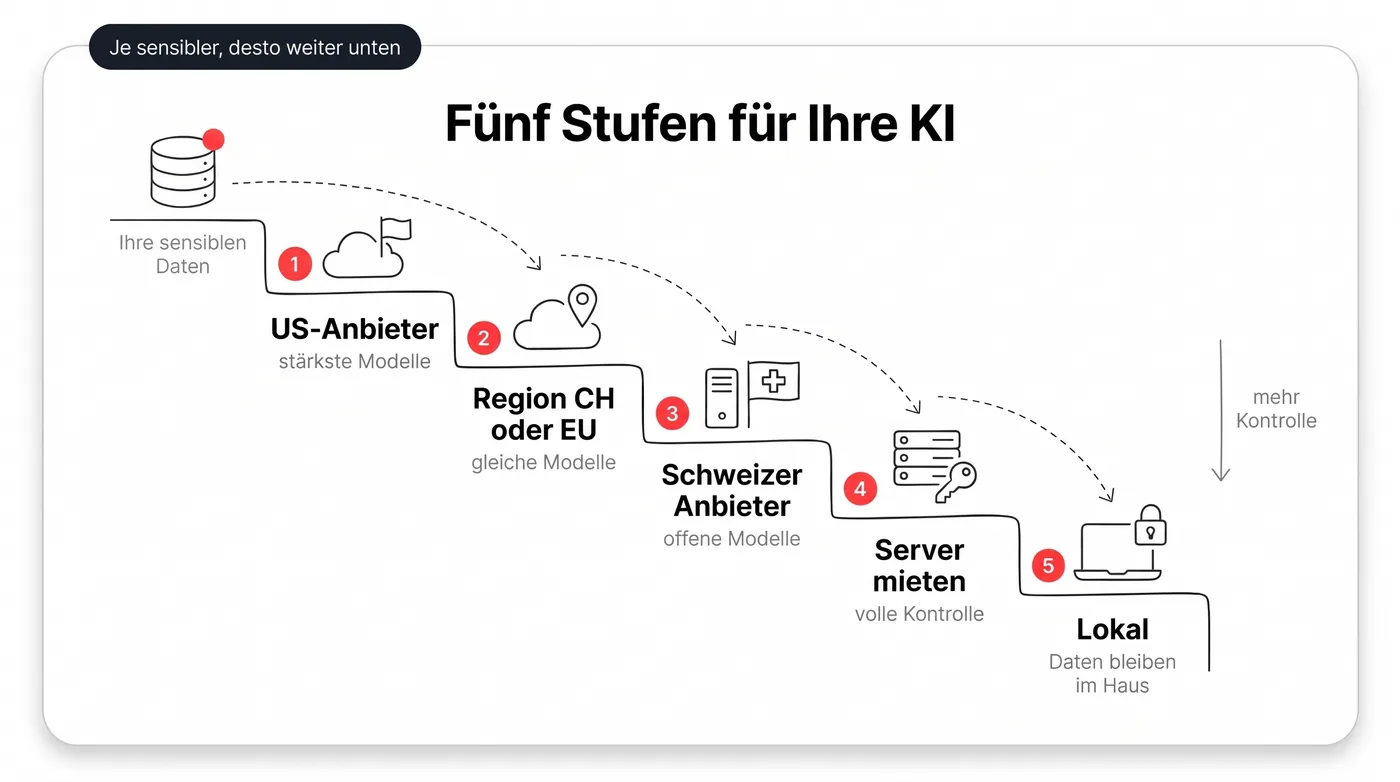
Dieser Artikel ordnet diese Wege als Treppe. Oben die bequeme Variante mit den stärksten Modellen, unten die Variante mit der meisten Kontrolle. Ich habe die Struktur aus einem deutschsprachigen Praxisvideo übernommen und auf Schweizer Verhältnisse umgebaut: andere Rechtslage, andere Anbieter, andere Regionen.
Zur Einordnung: Das ist eine technische Orientierung, keine Rechtsberatung. Stand: November 2026. Angebote, Regionen und Vertragsbedingungen ändern sich bei KI-Anbietern schneller als bei fast allen anderen Softwarekategorien. Prüfen Sie die aktuellen Angaben, bevor Sie sich festlegen. Für die rechtliche Beurteilung Ihres Falls fragen Sie eine Juristin oder einen Juristen.
Wenn Sie zuerst wissen wollen, welche Daten überhaupt in welches Tool dürfen, lesen Sie den Artikel KI datenschutzkonform nutzen. Dort geht es um die Fragen vor der Werkzeugwahl. Hier geht es um die Werkzeugwahl selbst, genauer: um den Standort.
Modell und Plattform: ein Unterschied, der alles ändert
ChatGPT ist eine Plattform. Eine App mit Chatfenster, betrieben von OpenAI. Das Modell dahinter lässt sich aber auch direkt ansprechen, über eine Schnittstelle, die man API nennt. Genau so läuft KI in den meisten Betrieben, sobald sie über das reine Chatten hinausgeht: in einer Automatisierung, die Anfragen sortiert, oder in einer eigenen Anwendung.
Für den Datenschutz zählen deshalb nur zwei Fragen.
Wohin gehen meine Eingaben? Bei den grossen Anbietern oft auf einen Server in den USA.
Was passiert dort damit? Werden sie gespeichert, wie lange, und fliessen sie in das Training neuer Modelle ein?
Bei bezahlten Schnittstellen und Geschäftsverträgen der grossen Anbieter werden Eingaben nach deren Angaben nicht fürs Training verwendet. Gespeichert werden sie aber meist trotzdem für eine begrenzte Zeit, häufig rund 30 Tage, zum Beispiel zur Missbrauchsprüfung. Das ist keine Verfehlung, sondern Standard. Es ist nur gut, es vorher zu wissen.
Als Beispiel nehme ich im ganzen Artikel eine Kundenmail mit Name und Adresse, die eine KI zusammenfassen soll. Sie ist das ehrlichste Testbild, weil sie so alltäglich ist.
Nicht jede Eingabe ist heikel
Bevor es die Treppe hinuntergeht, eine Entlastung. Ein Text von Ihrer eigenen Website enthält keine Personendaten. Eine Prozessbeschreibung ohne Namen ebenfalls nicht. Für solche Inhalte können Sie die grossen Anbieter ohne Bedenken direkt nutzen. Es ist nicht grundsätzlich falsch, ein US-Modell zu verwenden. Es kommt darauf an, was Sie ihm geben.
Heikel wird es bei Personendaten, also bei unserer Kundenmail. Noch heikler bei Gesundheits-, Lohn- und Finanzdaten oder bei Informationen unter einem Berufsgeheimnis.
Was in der Schweiz anders ist als in Deutschland
Die meisten Videos und Artikel zu diesem Thema sind auf Deutschland und die DSGVO zugeschnitten. In der Schweiz gelten dafür andere Regeln, und ein paar davon machen die Lage einfacher, als sie auf den ersten Blick wirkt.
Das Datenschutzgesetz, nicht die DSGVO. Massgebend ist das revidierte Schweizer Datenschutzgesetz, in Kraft seit dem 1. September 2023. Die DSGVO kann zusätzlich gelten, etwa wenn Sie Kundschaft in der EU haben. Für die Treppe heisst das: Der Standort allein ist kein Ja oder Nein, sondern eine Frage der Absicherung.
Auftragsbearbeitung statt Auftragsverarbeitung. Wenn ein Anbieter Personendaten in Ihrem Auftrag bearbeitet, braucht es einen Vertrag, der festhält, dass er das nur nach Ihren Weisungen tut. Die grossen Anbieter stellen ihn bereit, vor allem bei Geschäftskonten und über die Schnittstelle. Im Video heisst das DPA. In der Schweiz sagt man Auftragsbearbeitungsvertrag.
Der Datentransfer in die USA ist anders geregelt. Die Bekanntgabe von Personendaten ins Ausland ist erlaubt, wenn dort ein angemessener Datenschutz besteht. Für die USA hat der Bundesrat dafür das Swiss-US Data Privacy Framework anerkannt, seit September 2024. Gemeint sind US-Unternehmen, die sich dort zertifiziert haben. Ob ein Anbieter zertifiziert ist, lässt sich im öffentlichen Verzeichnis auf dataprivacyframework.gov nachschlagen. Ich habe es für diesen Artikel getan: Microsoft ist dort gelistet, OpenAI und Anthropic habe ich unter diesen Namen nicht gefunden. Das heisst nicht, dass Sie diese Anbieter nicht nutzen dürfen. Der Transfer läuft dann nicht über das Framework, sondern über Standardvertragsklauseln mit Schweizer Zusatz, also vertragliche Bausteine, die in der Regel Teil des Auftragsbearbeitungsvertrags sind. Prüfen Sie den Stand selbst, bevor Sie sich darauf verlassen.
Das Berufsgeheimnis ist eine eigene Liga. Anwaltskanzleien, Arztpraxen und Banken unterliegen zusätzlich strafrechtlich geschützten Geheimnissen. Hier reicht ein guter Vertrag mit einem US-Anbieter oft nicht, um ruhig zu schlafen. Das ist der Bereich, in dem die unteren Stufen der Treppe ernsthaft ins Spiel kommen.
Der CLOUD Act. Mit diesem US-Gesetz können US-Firmen verpflichtet werden, Daten an US-Behörden herauszugeben, auch wenn die Daten ausserhalb der USA liegen. Dafür braucht es eine konkrete Anordnung, die Ihre Daten betrifft. Dasselbe Restrisiko tragen Sie bei Microsoft 365, das die meisten Schweizer Betriebe ohnehin nutzen. Ich halte es für ein eher theoretisches Risiko bei normalen Geschäftsdaten und schaue lieber darauf, was Sie überhaupt eingeben. Bei Berufsgeheimnissen sehe ich das anders.
Für den Zusammenhang mit dem EU AI Act und der Kennzeichnung von KI-Inhalten gibt es einen eigenen Artikel: KI-Kennzeichnungspflicht in der Schweiz.
Lokale KI oder Cloud: die Treppe auf einen Blick
Stellen Sie sich eine Treppe vor. Mit jeder Stufe nach unten gewinnen Sie Kontrolle über Ihre Daten. Dafür werden die verfügbaren Modelle tendenziell schwächer, und Sie tragen mehr Verantwortung für den Betrieb.
| Stufe | Wo läuft die KI | Vertragspartner | Modellstärke | Kontrolle |
|---|---|---|---|---|
| 1 | Direkte Schnittstelle bei OpenAI, Anthropic, Google | US-Konzern | am höchsten | gering |
| 2 | Dieselben Modelle in Schweizer oder EU-Region (Azure, AWS, Google) | US-Konzern | sehr hoch | mittel |
| 3 | Schweizer und europäische Anbieter, meist offene Modelle | Anbieter in CH oder EU | gut | hoch |
| 4 | Gemieteter Server mit eigener Grafikkarte | Hardware-Vermieter | je nach Modell | sehr hoch |
| 5 | Eigenes Gerät im Büro | niemand | je nach Hardware | am höchsten |
Sie müssen sich nicht für eine Stufe entscheiden. Sie können mehrere kombinieren und die Anfragen nach Datenart verteilen: unkritische Texte nach oben, die Kundenmail nach unten. Dazu später mehr.

Stufe 1: Direkt zu den grossen Anbietern
Sie nutzen die Modelle von OpenAI, Anthropic oder Google direkt über deren Schnittstelle. Das ist der bequemste Weg und bietet die stärksten Modelle.
Der Haken: Ihre Daten werden in den USA verarbeitet. Eine Datenspeicherung von null Tagen ist bei diesen Anbietern in der Regel nicht Standard. Für Personendaten brauchen Sie einen Auftragsbearbeitungsvertrag und eine tragfähige Grundlage für den Transfer in die USA, also die Zertifizierung des Anbieters unter dem Swiss-US Data Privacy Framework oder Standardvertragsklauseln.
Rechtlich ist das die Stufe mit der grössten Angriffsfläche, aber sie ist weder verboten noch ungewöhnlich. Viele Unternehmen arbeiten so, mit sauberen Verträgen, oft über Enterprise-Pakete. Und für alles ohne Personenbezug gibt es überhaupt keinen Grund, sich Gedanken zu machen.
Wann passt das? Öffentliche Inhalte, interne Texte ohne Namen, Entwürfe, Recherche.
Stufe 2: Dieselben Modelle, aber in einer Schweizer oder EU-Region
Hier wird es für die meisten KMU interessant. Sie nutzen weiterhin Modelle wie die von OpenAI oder Anthropic, aber nicht direkt beim Hersteller, sondern bei einem Cloud-Anbieter, mit dem Sie vielleicht ohnehin schon einen Vertrag haben. Die Verarbeitung läuft dann in einem Rechenzentrum in der gewählten Region.
Die gängigen Wege:
Microsoft Azure. Die OpenAI-Modelle laufen dort in wählbaren Regionen. Azure betreibt Rechenzentren in der Schweiz, und je nach Modell lässt sich die Verarbeitung auf Schweiz oder EU begrenzen. Entscheidend ist die Auswahl beim Einrichten: Nur wenn Sie die richtige Region oder Datenzone wählen, bleiben die Anfragen auch dort.
Amazon Bedrock. Dort stehen unter anderem die Claude-Modelle bereit. AWS hat eine Region in Zürich und weitere in der EU. Bei der Modellverfügbarkeit gibt es regionale Unterschiede.
Google Cloud. Mit Regionen in Europa und in der Schweiz, ebenfalls mit regional abweichendem Modellangebot.
Der Haken, den man kennen sollte: Neue Modelle kommen in den Regionen oft später als in den USA. Wer unbedingt das allerneueste Modell braucht, schaut möglicherweise in die Röhre. Und der Vertragspartner bleibt ein US-Konzern, womit das CLOUD-Act-Restrisiko bleibt. Auch hier gilt: Prüfen Sie vor der Begeisterung, ob genau das Modell, das Sie wollen, in genau der Region verfügbar ist, die Sie wollen. Das ist die häufigste Falle auf dieser Stufe.
Diese Stufe sehe ich in der Praxis am häufigsten. Sie sind vertraglich abgesichert, bekommen Modelle auf Spitzenniveau, und für viele Datenschutzverantwortliche ist "läuft in der Schweiz oder EU, bei einem Anbieter, den wir schon kennen" ein überzeugendes Argument.
Eine Stufe weiter gehen sogenannte souveräne Clouds, bei denen auch der Betrieb in europäischer Hand liegt, mit eigener Gesellschaft und eigenem Personal. Beispiele sind die AWS European Sovereign Cloud in Brandenburg oder Delos von SAP für den deutschen Markt. Die Modellauswahl ist dort bisher klein, die grossen Modelle von OpenAI und Anthropic fehlen weitgehend, und wie unabhängig eine solche Cloud ist, solange sie einem US-Konzern gehört, wird unterschiedlich beurteilt. Für Schweizer KMU ist das heute kaum relevant, aber es lohnt sich, es im Auge zu behalten.
Wann passt das? Kundenkorrespondenz, Bewerbungen, interne Dokumente mit Personenbezug, sofern kein Berufsgeheimnis im Spiel ist.

Claude Code und andere Entwicklungswerkzeuge: ein Sonderfall
Bis hierher ging es um Automatisierungen, in denen ein Modell im Hintergrund etwas verarbeitet. Wenn Sie aber Projekte für Kundschaft umsetzen und dafür Werkzeuge wie Claude Code oder Codex nutzen, sieht die Rechnung anders aus. Solche Werkzeuge senden alles, was sie lesen, an das Modell. Also jede Datei in Ihrem Projekt.
Ich habe meine eigene Website totalexperience.ch mit Claude Code gebaut. Datenschutzmässig war das unkritisch: Eine öffentliche Website enthält keine Kundendaten, also konnte Claude Code alles lesen, ohne dass etwas Schützenswertes dabei war. Bei einem Kundenprojekt ist das selten so.

Bei Kundenprojekten ist genau das der Punkt. Die Faustregel:
Mit Testdaten arbeiten. Claude Code ist ein Entwicklungswerkzeug. Wenn Sie für Kundschaft eine Automatisierung oder App bauen, arbeiten Sie dabei mit erfundenen Beispieldaten. Ist die Lösung fertig und läuft beim Kunden, hat Claude Code keinen Zugriff mehr auf die Daten, die durch sie fliessen. Nur wenn die fertige Anwendung selbst ein KI-Modell einsetzt, stellt sich die Standortfrage erneut. Dann sind wir wieder bei Stufe 1 bis 5.
Abos und Geschäftsverträge unterscheiden. Die Privatabos (Free, Pro, Max) laufen nach den Nutzungsbedingungen für Privatpersonen. Das heisst nach Stand der Dinge: kein Auftragsbearbeitungsvertrag, und je nach Einstellung dürfen Gespräche für das Training verwendet werden. Prüfen Sie diese Einstellung und schalten Sie das Training aus. Einen Vertrag gibt es trotzdem nicht. Bedingungen ändern sich, darum lesen Sie die aktuelle Fassung in Ihrem Konto nach, statt sich auf diesen Artikel zu verlassen.
Echte Kundendaten brauchen Geschäftsbedingungen. Wenn Claude Code Ihre Kundenakten, Projektdaten oder Personendaten Dritter lesen soll, brauchen Sie einen Team- oder Enterprise-Plan oder einen API-Schlüssel aus der Entwicklerkonsole. Dort wird nicht auf Ihren Daten trainiert, und der Auftragsbearbeitungsvertrag ist Teil der Bedingungen. Die Verarbeitung findet allerdings bei dieser Variante in den USA statt, womit Sie wieder auf Stufe 1 stehen.
Soll es in der Region bleiben? Dann lassen sich Claude-Modelle über Amazon Bedrock in einer europäischen Region betreiben und in Claude Code einbinden. Claude Code ist letztlich ein Arbeitsrahmen, das Modell darin lässt sich austauschen. Bedenken Sie: Abgerechnet wird dort pro Token, nicht pauschal wie bei einem Abo. Wer täglich mehrere Stunden damit arbeitet, merkt das auf der Rechnung. Und die allerneuesten Modelle sind in den Regionen oft nicht sofort verfügbar.
Und gegenüber Ihrer Kundschaft? Sprechen Sie offen darüber, welche Werkzeuge Sie einsetzen und wo deren Daten verarbeitet werden. Das beruhigt mehr als jede Zertifizierung. Und wenn Sie Daten Ihrer Kundschaft in deren Auftrag bearbeiten, braucht es zwischen Ihnen und Ihrem Kunden einen Auftragsbearbeitungsvertrag. Setzt Ihr KI-Werkzeug diese Daten ein, gehört der Anbieter als Unterauftragnehmer in diesen Vertrag. So weiss Ihr Kunde, wer ausser Ihnen noch mitliest, und kann zustimmen oder ablehnen.
Stufe 3: Schweizer und europäische Anbieter
Das ist die konkreteste Option, wenn Ihr Vertragspartner nicht in den USA sitzen soll. Sie sprechen die Modelle weiterhin über eine Schnittstelle an, aber Anbieter und Rechenzentrum liegen in der Schweiz oder in Europa. Es gilt Schweizer beziehungsweise europäisches Recht.
Schweizer Anbieter. Infomaniak betreibt eigene Rechenzentren in der Schweiz und bietet über seine KI-Dienste offene Modelle an. Auch Swisscom betreibt mit der Swiss AI Platform eine KI-Plattform in der Schweiz, mit verwalteten Schnittstellen zu verschiedenen Modellen. Nach Angaben von Swisscom bleiben die Daten in der Schweiz und werden nicht von internationalen Tech-Konzernen genutzt. Das Angebot richtet sich eher an grössere Unternehmen, ein kleines KMU schaut darum zuerst bei den anderen Anbietern. Zu den Modellen gehört Apertus, ein offenes Schweizer Sprachmodell, das die ETH Zürich, die EPFL und das nationale Hochleistungsrechenzentrum CSCS entwickelt haben. Seine Gewichte sind frei verfügbar, es lässt sich also auch auf eigener Hardware betreiben. Was genau jeder Anbieter heute im Programm hat, ändert sich laufend. Schauen Sie auf die Seite des Anbieters, nicht auf diesen Absatz.
Europäische Anbieter. Mistral aus Frankreich entwickelt eigene Modelle. Scaleway aus Frankreich und Ionos oder StackIT aus Deutschland betreiben vor allem offene Modelle in europäischen Rechenzentren. Bei Scaleway etwa werden Eingaben nach Angaben des Anbieters standardmässig nicht gespeichert.
Was ist mit chinesischen Modellen? Das ist die Frage, die ich dazu am häufigsten höre. Offene Modelle aus China wie Qwen, GLM oder DeepSeek laufen bei diesen Anbietern auf deren eigenen Servern. Ihre Daten gehen also zum Hosting-Anbieter in Paris oder Zürich, nicht an den Hersteller in China. Das Modell ist am Ende eine Datei ohne Verbindung zu ihrem Hersteller. Anders sieht es aus, wenn Sie die App oder die Schnittstelle des Herstellers selbst benutzen. Wer in DeepSeek Chat tippt, schickt seine Daten tatsächlich nach China.
Der Preis. Die offenen Modelle sind pro Token deutlich günstiger als die Spitzenmodelle der grossen Anbieter. Das ist nicht überraschend, denn sie sind in der Regel auch weniger leistungsfähig. Aber nicht jede Aufgabe braucht ein Spitzenmodell. Man muss nicht mit dem Ferrari zum Bäcker fahren. Wer aus einer Kundenmail die Anfrage herausliest, sie einer Kategorie zuordnet und ins CRM schreibt, braucht dafür kein Hochleistungsmodell. Die meisten Geschäftsautomatisierungen, die ich sehe, drehen sich darum, unstrukturierten Text zu ordnen, darauf eine Entscheidung zu stützen und dann normalen Code auszuführen. Ein kleineres Modell kann das gut.
Ein Hinweis zu OpenRouter. Wer nicht bei jedem Anbieter einzeln einen Vertrag abschliessen will, kann einen Vermittler nutzen: Mit einer Anmeldung lassen sich Hunderte Modelle verschiedener Anbieter ansprechen. OpenRouter bietet dafür inzwischen auch eine EU-Variante, bei der Anfragen nur an europäische Rechenzentren gehen. Ist ein Modell dort nicht verfügbar, bekommen Sie eine Fehlermeldung, statt dass die Anfrage stillschweigend in den USA landet. Zusätzlich lässt sich einstellen, dass nur Anbieter ohne Datenspeicherung verwendet werden. Die EU-Variante ist an einen Business-Tarif gebunden.
Wann passt das? Personendaten, bei denen Sie keinen US-Vertragspartner wollen. Interne Auswertungen von Kundenkorrespondenz. Alles, wo "läuft in der Schweiz" ein Verkaufsargument gegenüber Ihrer eigenen Kundschaft ist.
Stufe 4: Einen eigenen Server mit Grafikkarte mieten
Jetzt wird es technisch. Sie mieten bei einem Anbieter einen Server mit einer leistungsstarken Grafikkarte und lassen das Modell selbst darauf laufen. Ihre Kundenmail geht dann an gar keinen Modellanbieter mehr, sondern nur noch an den Vermieter der Hardware. Alles andere kontrollieren Sie.
Gängige Anbieter sind Hetzner, Scaleway oder RunPod. Auch einzelne Schweizer Cloud-Anbieter haben Grafikkarten-Server im Angebot, das lohnt sich zu prüfen, wenn der Standort Schweiz für Sie Pflicht ist.
Abgerechnet wird meist nach Stunden, auch wenn gerade niemand fragt. Der Server steht zur Verfügung, und die Leistung wird in Rechnung gestellt. Bei RunPod läuft es sekundengenau und nur, solange die Karte rechnet. Das ist günstiger, hat aber einen Preis: Nach einer längeren Pause dauert die erste Antwort, weil das Modell neu geladen wird. Für sensible Daten bietet RunPod eine "Secure Cloud" an, und Anfragen werden dort nach der Verarbeitung gelöscht, nach Angaben des Anbieters spätestens nach einem Tag. RunPod ist allerdings ein US-Unternehmen, auch hier lässt sich die Region wählen.
Der Reiz an dieser Stufe: Sie können praktisch jedes offene Modell laden, auch solche, die bei den grossen Cloud-Anbietern in Europa gar nicht angeboten werden. Der Haken: Das Modell muss auf die Hardware passen. Kleine Modelle laufen auf einer einzigen Grafikkarte, grosse brauchen ein Vielfaches. Und geschlossene Modelle wie GPT oder Claude gibt es hier nicht.
Aus meiner Sicht lohnt sich Stufe 4 vor allem dann, wenn der Server gut ausgelastet ist, wenn Sie volle Kontrolle wollen und bereit sind, dafür mehr zu zahlen. Für ein Gerät, das nachts schläft, ist es die teuerste Variante pro Anfrage.

Stufe 5: Lokale KI auf dem eigenen Gerät
Das ist die letzte Stufe: Sie kaufen die Hardware und betreiben die KI selbst. Man spricht dann von lokaler KI, oder fachlich davon, ein LLM lokal zu betreiben. Ihre Kundenmail verlässt das Gerät nie. Es gibt keinen Anbieter, dem Sie vertrauen müssen. Das ist die sicherste Variante und gleichzeitig die anspruchsvollste.
Zum Verständnis: Ein KI-Modell ist im Kern eine riesige Datei mit Milliarden von Zahlen, den sogenannten Gewichten. Bei offenen Modellen kann man diese Datei herunterladen und ohne Verbindung zum Hersteller nutzen. Nur sind diese Dateien gross. Die grössten Modelle brauchen in voller Genauigkeit über ein Terabyte, und zwar nicht auf der Festplatte, sondern im Arbeitsspeicher, idealerweise im Speicher der Grafikkarte. Eine gute Grafikkarte für zu Hause hat rund 32 GB.
Darum laufen lokal kleinere oder "quantisierte" Modelle. Quantisieren heisst: Jede Zahl im Modell wird mit weniger Genauigkeit gespeichert, ähnlich wie ein Foto mit weniger Farbabstufungen. Die Datei wird deutlich kleiner, und der Qualitätsverlust bleibt je nach Verfahren gering. Ein Modell mit 27 Milliarden Parametern schrumpft so von rund 54 auf rund 26 GB.
Drei Dinge sollten Sie vor einem Kauf wissen.
Geschwindigkeit. Auf einem kompakten KI-Rechner wie dem Nvidia DGX Spark läuft ein grosses offenes Modell mit etwa 50 Tokens pro Sekunde. Tokens sind die Wortfragmente, aus denen die KI ihre Antwort baut. Das ist schneller, als Sie lesen können. Sobald aber mehrere Personen gleichzeitig Anfragen stellen, teilen sie sich die Leistung, und alle warten etwas länger. Für eine Automatisierung, die im Hintergrund Mails sortiert, spielt das keine Rolle. Für einen Chatbot mit vielen gleichzeitigen Nutzern eher doch. Dann wäre ein Server die bessere Wahl.
Kontextfenster. Das ist die Textmenge, die ein Modell auf einmal verarbeiten kann. Offene Modelle schaffen derzeit meist zwischen 128'000 und 256'000 Tokens, die grossen kommerziellen Modelle bis zu einer Million, das entspricht rund 750'000 Wörtern. Für die meisten Alltagsaufgaben reichen 100'000 bis 200'000 Tokens völlig. Anders ist es nur, wenn Sie viele Dokumente gleichzeitig auswerten wollen.
Hardwarepreise. Wegen des KI-Booms sind gute Rechner teurer geworden, als sie vor ein, zwei Jahren waren. Für viele lohnt sich die Anschaffung trotzdem.
Testen, bevor Sie kaufen
Ehrlich gesagt ist das der Tipp, den ich am meisten schätze. Bevor Sie einen teuren Rechner bestellen, testen Sie in zwei Schritten.
Erst probieren Sie das Modell, das Sie im Auge haben, mit Testdaten aus, zum Beispiel über OpenRouter oder bei einem Anbieter der Stufe 3. Löst es Ihre Aufgabe gut genug? Wenn ja, mieten Sie für ein paar Stunden eine Grafikkarte, die ungefähr der Hardware entspricht, die Sie kaufen würden, und lassen das Modell dort laufen. So sehen Sie, ob es überhaupt auf die Hardware passt und schnell genug ist. So kaufen Sie keinen Rechner, der zu klein oder viel zu gross ist.
Lokale Modelle sind inzwischen gut genug, um viele Alltagsaufgaben in einem Betrieb zu übernehmen. Kundenmails zusammenfassen gehört sicher dazu.
Was lokale KI gut kann und was nicht
Gut geeignet: Texte zusammenfassen, Mails nach Thema sortieren, Daten aus Dokumenten herauslesen, Entwürfe für Standardantworten. Das sind Aufgaben mit klarem Rahmen, bei denen ein kleineres Modell reicht und bei denen es wichtig ist, dass die Inhalte das Haus nicht verlassen.
Weniger geeignet: Sehr komplexe Programmieraufgaben, lange Analysen über viele Dokumente gleichzeitig und alles, was die allerstärksten Modelle braucht. Dort liegen die Spitzenmodelle der grossen Anbieter vorne. Und wer mehrere Personen gleichzeitig bedienen will, stösst auf einem einzelnen Gerät schneller an Grenzen.
Für den Einstieg gibt es Programme wie Ollama oder LM Studio, die ein offenes Modell auf dem eigenen Rechner starten und eine Eingabeoberfläche mitbringen. Wer ein lokales Modell später in eine Automatisierung einbinden will, kann es ähnlich wie eine Cloud-Schnittstelle ansprechen. Damit lässt sich ein Ablauf zuerst mit Stufe 3 testen und später auf lokal umstellen, ohne ihn neu zu bauen.
Wann passt das? Besonders schützenswerte Daten in einem einzelnen Prozess. Berufsgeheimnisse. Alles, wo "die Daten verlassen das Haus nicht" Voraussetzung ist.
Welche Stufe zu welcher Datenart passt
Eine grobe Zuordnung, nach Daten statt nach Technik:
| Daten | Beispiel | Naheliegende Stufe |
|---|---|---|
| Öffentlich | Website-Texte, Broschüren, Inserate | 1 |
| Intern, unkritisch | Prozessbeschreibungen, Vorlagen, Entwürfe | 1 oder 2 |
| Personenbezogen | Kundenmails, Bewerbungen, Supportanfragen | 2 oder 3 |
| Besonders schützenswert | Gesundheits-, Lohn-, Finanzdaten, Verträge | 3, 4 oder 5 |
| Unter Berufsgeheimnis | Mandantendossiers, Patientenakten | 4 oder 5, mit Fachperson |
Das ist eine Faustregel, kein Urteil. Die Zuordnung für Ihren Betrieb bespricht am Ende eine Fachperson mit Ihnen. Hilfreich ist sie trotzdem, weil sie die Diskussion vom Allgemeinen ("KI und Datenschutz") ins Konkrete holt: Diese Aufgabe, diese Daten, diese Stufe.
Stufen lassen sich kombinieren
Das ist der Punkt, den viele übersehen. Sie müssen sich nicht für eine Stufe entscheiden. Ein Ablauf kann pro Anfrage unterschiedlich routen: Eine Mail ohne Personenbezug geht an ein starkes Modell der Stufe 2, eine Mail mit Kundendaten an einen Schweizer Anbieter der Stufe 3, ein Dokument unter Berufsgeheimnis an ein Modell auf eigenem Gerät. Wie sich solche Abläufe mit n8n bauen lassen, steht im Überblick zur Automatisierung von Geschäftsprozessen. Wer lieber eine fertige Oberfläche für das Team will, findet im Vergleich Langdock gegen Logicc zwei Plattformen, die mehrere Modelle bündeln.
Fünf Fehler, die ich bei diesem Thema sehe
Alle Daten wie Patientenakten behandeln. Wer jede Anfrage auf Stufe 5 hebt, löst ein Problem, das er nicht hat, und bekommt am Ende Schatten-KI mit privaten Accounts.
Die Region nicht festlegen. Bei Azure, AWS und Google ist die Region eine Einstellung beim Einrichten. Wird sie nicht gesetzt oder falsch gewählt, laufen die Anfragen woanders, als Sie denken.
Ein Modell wählen, bevor die Verfügbarkeit geprüft ist. Nicht jedes Modell läuft in jeder Region. Wer sich auf ein bestimmtes Modell festlegt und danach feststellt, dass es in der Schweiz nicht verfügbar ist, plant neu.
Einen eigenen Server mit Datenschutz verwechseln. Ein eigener Server hilft nur bei den Daten, die tatsächlich darauf bleiben. Wenn Ihr Ablauf am Ende alles an ein Modell in einem Drittstaat schickt, haben Sie den Standort verschoben und sonst nichts.
Nie mit der Kundschaft darüber sprechen. Viele Betriebe fürchten, dass die Frage nach dem Standort Kundschaft verunsichert. In meiner Erfahrung ist es umgekehrt. Wer offen sagt, welche Werkzeuge er nutzt und wo die Daten verarbeitet werden, schafft Vertrauen. Manche Kunden wollen nur wissen, dass es in Europa bleibt. Andere wollen alles lokal. Das entscheiden sie, nicht Sie.
Wann ich keine Empfehlung für eine tiefere Stufe machen würde
Nicht jeder Betrieb gehört auf Stufe 4 oder 5, und ich rate in solchen Fällen ausdrücklich ab. Wenn Ihre Daten öffentlich oder unkritisch sind, löst eine tiefere Stufe ein Problem, das Sie nicht haben, und kostet laufend Zeit und Geld. Wenn Ihr Team keine Kapazität hat, einen eigenen Server zu pflegen, ist ein Anbieter der Stufe 3 fast immer die bessere Wahl. Und wenn niemand weiss, welche Daten überhaupt in die KI gehen, ist nicht der Standort das Problem, sondern die fehlende Einstufung. Die klären Sie zuerst.
Häufige Fragen
Was ist eine lokale KI?
Eine lokale KI ist ein Sprachmodell, das auf Ihrem eigenen Gerät oder Server läuft, statt bei einem Anbieter in der Cloud. Ihre Eingaben verlassen das Gerät nicht. Dafür nutzen Sie offene Modelle, die sich herunterladen lassen. Die Spitzenmodelle von OpenAI, Anthropic und Google gibt es nicht zum Herunterladen.
Wie kann ich eine KI lokal installieren?
Mit Programmen wie Ollama oder LM Studio lässt sich ein offenes Modell auf dem eigenen Rechner starten. Entscheidend ist, ob das Modell in den Speicher Ihrer Grafikkarte passt. Prüfen Sie das vor dem Kauf, am besten mit dem Zweistufentest aus dem Abschnitt zu Stufe 5.
Ist ChatGPT datenschutzkonform?
Das hängt vom Konto und von den Daten ab, nicht vom Produktnamen. Mit einem Geschäftskonto oder über die Schnittstelle werden Eingaben nach Angaben von OpenAI nicht fürs Training verwendet, und es gibt einen Auftragsbearbeitungsvertrag. Bei privaten Konten sieht das anders aus. Für Personendaten ist eine Stufe mit Schweizer oder EU-Verarbeitung die einfachere Wahl. Die Einstufung Ihrer Daten steht im Artikel KI datenschutzkonform nutzen.
Gibt es KI-Hosting in der Schweiz?
Ja. Schweizer Anbieter wie Infomaniak und Swisscom betreiben KI-Dienste in Schweizer Rechenzentren. Dazu kommen die Schweizer Regionen der grossen Cloud-Konzerne, etwa von Microsoft, Amazon und Google. Welche Modelle in welcher Region verfügbar sind, unterscheidet sich je nach Anbieter und ändert sich laufend, darum lohnt sich die Prüfung vor dem Entscheid.
Müssen KI-Daten in der Schweiz bleiben?
Nein, nicht grundsätzlich. Eine Bekanntgabe ins Ausland ist erlaubt, wenn dort ein angemessener Datenschutz besteht oder vertragliche Absicherungen vorliegen. Für die USA gilt das für Unternehmen, die unter dem Swiss-US Data Privacy Framework zertifiziert sind, ansonsten braucht es Standardvertragsklauseln. Für besonders schützenswerte Daten und Berufsgeheimnisse ist Verarbeitung in der Schweiz trotzdem die deutlich einfachere Wahl.
Ist ChatGPT im Unternehmen erlaubt?
Das hängt von den Daten und vom Konto ab. Für öffentliche und unkritische interne Inhalte meistens ja. Für Personendaten sollten Sie ein Geschäftskonto mit Auftragsbearbeitungsvertrag nutzen, bei dem Ihre Eingaben nicht für das Training verwendet werden. Mehr dazu im Artikel KI datenschutzkonform nutzen.
Was bringt eine lokale KI im Unternehmen?
Maximale Kontrolle: Die Daten verlassen Ihr Gerät nie, und es gibt keinen Anbieter, dem Sie vertrauen müssen. Dafür sind lokale Modelle kleiner als die Spitzenmodelle der grossen Anbieter, und mehrere gleichzeitige Nutzer verlangsamen sich gegenseitig. Für Aufgaben wie Mails sortieren oder zusammenfassen reichen sie aber oft aus.
Ist ein Server in der Schweiz automatisch sicherer?
Nein. Der Standort ist nur ein Faktor. Entscheidend sind auch Vertrag, Zugriffsrechte und die Frage, ob Ihre Daten am Ende der Kette tatsächlich dort bleiben. Ein Schweizer Rechenzentrum, das Anfragen an ein Modell im Ausland weiterreicht, hilft wenig.
Was ist der CLOUD Act und muss ich mir deswegen Sorgen machen?
Der CLOUD Act ist ein US-Gesetz, das US-Firmen verpflichten kann, Daten an US-Behörden herauszugeben, auch wenn die Daten in einer anderen Region liegen. Dazu braucht es eine konkrete Anordnung. Für normale Geschäftsdaten halte ich das Risiko für eher theoretisch, es betrifft auch Microsoft 365. Bei Daten unter Berufsgeheimnis ist die Einschätzung eine andere, und dort lohnt sich ein Schweizer oder lokaler Weg.
Kann ich mehrere Stufen kombinieren?
Ja, und das ist oft die beste Lösung. Ein Ablauf kann Anfragen je nach Datenart an unterschiedliche Modelle schicken: unkritische Texte an ein starkes Modell in einer Cloud-Region, Kundendaten an einen Schweizer Anbieter und besonders schützenswerte Dokumente an ein lokales Modell.
Darf ich Claude Code für Kundenprojekte nutzen?
Ja, wenn Sie sauber arbeiten. Als Entwicklungswerkzeug eignet es sich gut, solange Sie mit Testdaten arbeiten. Sobald echte Kundendaten im Projekt liegen, brauchen Sie Geschäftsbedingungen mit Auftragsbearbeitungsvertrag, also einen Team- oder Enterprise-Plan oder einen API-Schlüssel. Wenn die Daten in Europa bleiben sollen, ist eine europäische Cloud-Region eine Möglichkeit. Informieren Sie Ihre Kundschaft offen darüber.
Wie kann ich testen, welche Stufe zu mir passt?
Fangen Sie mit Testdaten an. Probieren Sie ein Modell über einen Anbieter der Stufe 3 oder über OpenRouter aus und prüfen Sie, ob es Ihre Aufgabe gut genug löst. Erst danach lohnt sich die Frage, ob dafür eine Stufe mit mehr Kontrolle nötig ist.
Welche Aufgaben lassen sich bei Ihnen automatisieren?
Wir gehen Ihre Abläufe gemeinsam durch und suchen die Stellen, an denen sich manuelle Arbeit abgeben lässt.
Gespräch vereinbarenOder direkt schreiben:micha.schindler@totalexperience.ch
Was Sie erwartet
- Per Videocall
- 30 Minuten · kostenlos · unverbindlich
- Ich erkläre alles ohne Fachbegriffe
- Kein Angebot, wenn es nicht passt
- Sie entscheiden danach, ohne Druck